本文由参与实验的AI依据保存的任务记录、程序产物与验证日志协作整理;文中的“我”指发起实验的站长。只公开可核验的过程与结果,不公开完整私有会话。
先把结果和边界放在一起:我把《密码故事》(The Code Book)末尾十关挑战的14张照片交给AI,禁止联网,让它真正解出正文,而不只是报十个答案词。从首次提交照片开始,2小时10分10秒读出最后一题全文,2小时27分41秒完成统一复核和交付。
这不是“AI从零用两小时破解512位RSA”。第9关确实进行了GPU密钥搜索;第10关则使用了模型已有知识提出的历史因子候选,取得真实模数后,才通过整除、素性检查、RSA回验和完整明文验证接受它。模型记得的其他长整数,不少是错的。
这里的“离线”指解题阶段不检索互联网,不代表模型运行在本机或机器物理断网;模型调用仍通过API进行,本地已有文档、工具和缓存语料可以使用。
我负责发起实验、提供关键提示、批准必要计算,并在AI过早准备停下或误判环境时把方向拉回来。转录辅助程序、密码分析代码、CUDA搜索器和验证脚本,主要由主agent及worker生成、运行和修订,不是我手写了全部实现。
解题阶段主模型与所有worker均为 openai-codex/gpt-6-astra,累计启动16个子任务,包含取消、未命中和重复工作被终止的任务,不是16个同时运转的成功解题者。解完并交付以后,我才允许联网核对历史资料。原始照片、初始转录和离线失败记录保留,没有拿网上答案回填成“当时就知道”。
最终结果如下:
| 关卡 | 实际口令 | 核心机制 |
|---|---|---|
| 1 | OTHELLO | 单字母替换 |
| 2 | NEUTRON | 凯撒移位 |
| 3 | EQUATOR | 同音替换,含空格符 |
| 4 | TRAJAN | Vigenère,密钥SCUBA |
| 5 | ILLIAD | 费马拉丁页边注记的字母索引 |
| 6 | MOLYBDENUM | Playfair |
| 7 | EDISON | 8×8坐标替换与8列换位 |
| 8 | PLUTO | Enigma |
| 9 | ARMSTRONG | DES-ECB,实际GPU搜索 |
| 10 | DRYDEN | RSA恢复密钥,长密文实测为单DES-ECB |
十个首字母连起来是 ONE TIME PAD。它是漂亮的交叉线索,不是用来猜填未解口令的许可证。
一、不是十道孤立题,也不是把任务平均分成十份
这套挑战有两种依赖。一种是计算依赖:第10关照片只给短整数和长密文,RSA公钥藏在第9关正文里。另一种是信息依赖:第6关说明第7关是什么类型,第7关指出第8关转子图有错,第8关又给第9关密钥前缀与实现测试向量。
所以主agent可以并行准备,却不能假装所有参数一开始就齐了。早期开出的任务是第1—3关、第4—6关,以及第7、8、9、10关各一支;随着结果回来,再增开专项搜索和独立审计。
下面按启动顺序列出全部16项。这里的“完成任务”和“解出题目”是两回事:
| # | 分工 | 实际贡献或停止原因 |
|---|---|---|
| 1 | 第1—3关 | 完整解出三关,保存映射与回验 |
| 2 | 第4—6关 | 解出4、6,完成5的数字转录 |
| 3 | 第7关 | 解出EDISON,并传回转子互换提示 |
| 4 | 第8关初轮 | 新线索到来后取消,保留已有程序 |
| 5 | 第9关初轮 | UU转录、DES测试向量和CPU搜索器;未解出主文 |
| 6 | 第10关初轮 | 提取两段密文、准备RSA/DES工具;未解出 |
| 7 | 第5关独立搜索 | 大量底本与索引试验未命中,后取消 |
| 8 | 第8关正确转子重启 | 解出PLUTO,并审计等价环位 |
| 9 | 第5关第二轮 | 费马拉丁文命中,得到ILLIAD |
| 10 | 第10关历史参数与高位补全 | 构建Coppersmith、区间纠错工具;否定多条错误候选 |
| 11 | 第9关独立审计 | 核验方向与模式,复核GPU真钥,校读三处UU误识,恢复真实RSA参数 |
| 12 | 第10关独立混合加密 | IDEA支线未命中;后来转为最终RSA/DES链交叉复核 |
| 13 | 第9关CUDA位切片 | 生成S盒电路、迭代搜索器并找到真实密钥 |
| 14 | 第9关旧PRNG支线 | 有界种子与映射测试,无命中 |
| 15 | 独立历史记忆核对 | 以原团队信息尝试召回候选,没有验证通过的参数 |
| 16 | 第10关真实模数因子任务 | 主agent先验证出正确因子,取消该支避免重复计算 |
这次写作及后续发布整理不算进上述16项。
有效的协作不是让十几个模型各说各话,而是传递具体产物:一段已解明文、一张映射表、一条被否定的假设、一组可重跑的测试。尤其是第7关的转子提示,必须及时进入第8关;第9关的真实模数,也必须替换第10关所有尚未认证的记忆版本。
实验跨越2026年10月24日晚至25日凌晨。几个可核验的里程碑是:
| 事件 | 时间,UTC+8 |
|---|---|
| 提交照片与任务 | 22:01:22 |
| 第5关独立复核通过 | 23:10:22 |
| 第9关GPU命中并停止 | 23:50:21 |
| 次日,第10关因子验证通过 | 00:03:02 |
| 第10关全文首次解出 | 00:11:32 |
| 十关统一复核全部PASS | 00:27:26 |
| 最终交付 | 00:29:03 |
这是会话墙钟时间,包含编程、交流、等待、失败、暂停和整理,不是所有agent耗时相加,更不是纯GPU运行时间。
它并不是一路顺利地通关。第一轮约52分钟后,AI交回的是7/10完成报告,第5、9、10关仍未解出。我随后明确第5是书本密码,提醒它这套挑战早在2000年就已有团队完成,要求继续;又提示第10关嵌套两层。这些是人类提供的真实输入,应该记入经过,不能删掉以后包装成完全无提示的自主实验。
二、第一道关卡其实是照片,而不是密码
输入是HEIC照片,不是可直接复制的密文。已有JPEG预览约为1013×1800,而原图为2268×4032。对普通段落差别不大,对密密麻麻的UU编码和弯曲书页上的大写字母,差别很大。
worker在本地用ImageMagick转换原分辨率图像,Tesseract提供OCR草稿,再做裁切、模板识别和低置信字形复核。第7关足足占六页,采用OpenCV分割字形后再识别,并把允许字母限制为题面真正出现的八种符号。最后修正11处识别错误,得到7048个符号。
这里必须区分三个层次:
- 照片原件:不改。
- 初始转录:保留,允许它有错。
- 有证据的校订版:另存,逐项说明依据。
“把转录重新编码,能得到原来的转录”,只证明程序内部自洽,不能证明照片没有抄错。第9关后来出现的 O/0、S/$、2/Z 就是在打这个脸。它们都可能是合法UU字符,长度检查和编码往返不会报警。
同样,解出的是文学作品,也不能拿记忆中的标准版本覆盖题面。第3关的意大利文缺字、第4关被手写线覆盖的一个字母,都需要明确保存原读法。密码分析要忠于输入,不是替原作者做编辑。
三、第1—4关:古典密码里,最容易错的是先入为主
第1关:从词形建立整张单表
第1关保留空格和标点,明显适合单字母替换分析。高频三字组 JPX,结合 JPX HBTW'R 和 M LMT'R,可以建立 THE KING'S、A MAN'S 的对应;开头进一步成为 IN THE SAME HOUR。
worker沿全文词形补全了26字母双射,而不是只认出一个“Daniel”就宣布成功:
密文 ABCDEFGHIJKLMNOPQRSTUVWXYZ
明文 CIOVYBLKFTQMADZHPSJNURGEWX
委派任务时,主agent一度把出处猜成《但以理书》第一章;全文验证后才纠正为第五章5—12节。任务提示中的背景猜测也可能污染后续分析,不能把它当作已证事实。
正文是王宫墙上出现书写之手的故事,末句直接写着:
THE FIRST CODEWORD IS OTHELLO.
全部正文按同一张表解开,再重新加密与转录逐字节一致。出处辨认帮助理解,但不是密钥验证的替代品。
第2关:枚举26个移位,但别只用英语判断
A编号为0,对每个字母计算:
P = (C - 7) mod 26
结果是拉丁文,而不是英文:
FABER EST SUAE QUISQUE FORTUNAE APPIUS CLAUDIUS CAECUS
DICTUM ARCANUM EST NEUTRON
前一句意为“每个人都是自己命运的工匠”,后一句给出秘密词NEUTRON。26种移位全部检查后,再加7恢复密文。若评分器只认可英语,很容易把正确候选排低。
第3关:不是一对一替换,X也不是普通字母
这关1120个符号中,X 解为空格,* 解为L;M/G/C/Z/N/B 六个不同符号都解为A。若强迫密文与明文字母一一对应,约束从一开始就错了。
完整映射可以写成:
密文 * A B C D E F G H I J K L M N O P Q R S T U V W X    Y Z
明文 L B A A F S I A Z O G V D A A H U E Q C N T R M 空格 P A
开头成为 O FRATI DISSI CHE PER CENTO MILIA,全文是但丁《地狱篇》第二十六歌的远航片段,末尾明确给出 LA PAROLA IN CODICE E EQUATOR。
反向验证比前两关多一个细节:一个A有六种编码,只有明文和映射表,不能唯一恢复原密文。验证文件因此额外保存这条消息实际选择各同音符号的次序,再据此重建,而不声称存在唯一的反向加密。
照片里确实出现 FATI 而非通常诗文的 FATTI,以及缺字的 ACQUSTANDO。这些没有被悄悄润色。严格解密文本和便于阅读的版本,应当分开。
第4关:SCUBA是密钥,TRAJAN才是口令
对604个字母按候选周期分列,周期1的平均重合指数约0.0439,周期5升至约0.0787。重合指数衡量同一序列随机取两个符号相同的概率;正确拆开Vigenère周期后,每列重新接近自然语言的偏斜分布。
每列再试26种凯撒移位,得到密钥 SCUBA:
P_i = (C_i - K_(i mod 5)) mod 26
解出波德莱尔《信天翁》,其中插入 LE MOT POUR ETAGE QUATRE EST TRAJAN。提交词是TRAJAN,不是SCUBA。
末尾第602个字母有手写覆盖:按印字U读,得到 MARCSER;校订成J,得到标准法文 MARCHER。两版都保存并分别往返验证,差异明确限定为这一处,口令不受影响。这里的诚实不是拒绝校订,而是不隐藏校订。
四、第5关:几百万次错误底本搜索,也不会自动接近正确答案
第5关只有54个整数,最小3、最大217,共43个不同值。看起来比Enigma短得多,却是最容易困在错误问题表述里的关卡。
第一轮确实做了大规模搜索,不是“试了两本书就放弃”:前几关明文、不同拼接和顺序,名篇开头、《圣经》、独立宣言、书的前言与其他记忆片段;取整词、词首、词尾、字母位置,改变分词、偏移和方向。仅整词索引,就扫描了约277万处英语、293万处法语语料起点,另有多轮几十万级候选提取。
结果全部没有完整可读命中。四元组分数还会把满是E、S、T的乱码排在前面。高分不是句子,找不到底本也不等于书本密码不成立。
我在过程中确认了book cipher方向,要求继续,不能因为若干熟悉文本失败就停止。第二轮换了候选空间:不再主要盯着小说和文章开头,而是检查短文本、书名目录、前关内容以及费马相关文字。第7关已经解出的费马传记,让这一类候选值得测试,但不能因此直接认定答案。
真正命中的是模型已有知识提供的费马拉丁文页边注记:
Cubum autem in duos cubos, aut quadratoquadratum in duos quadratoquadratos, et generaliter nullam in infinitum ultra quadratum potestatem in duos eiusdem nominis fas est dividere cuius rei demonstrationem mirabilem sane detexi. Hanc marginis exiguitas non caperet.
去掉标点和空格,仅保留A—Z并转大写,恰为225个字母。密文整数从 1 开始索引这个串,没有循环、偏移或为了答案补字。最短的核心代码就是:
letters = ''.join(c for c in latin.upper() if 'A' <= c <= 'Z')
assert len(letters) == 225
plaintext = ''.join(letters[n - 1] for n in numbers)
例如109、182、6、11依次取到P、L、A、I;54项完整输出为:
PLAIFAIRCIPHERESELPROXIMONIVELLAPALABRASECRETAESILLIAD
分词后是西班牙语夹英文术语:“下一关是Playfair密码;秘密词是ILLIAD。”
两处奇怪拼写必须保留:**PLAIFAIR,不是PLAYFAIR;ILLIAD,双L,不是ILIAD。**底本没有Y,能解释为什么不能直接编码PLAYFAIR,却不能据此编造作者具体采用了什么替代规则。最后六项 86 96 73 177 50 161 实际就是 I L L I A D。
另一个反直觉点是:最高频数字109解出来是P,不是E。它恰好出现在PLAIFAIR、CIPHER、PROXIMO、PALABRA中。对这么短的索引密文,硬套一般语言频率很危险。
主agent另外重建底本并独立计算全部54项。常见的 eiusdem/ejusdem、cuius/cujus 拼写变体只影响两个未被引用的位置,不影响答案。同字母在底本里有多个位置,反向重建仍需记录原题的出现位置选择,不能把非唯一编码伪装成唯一。
五、第6关:Playfair能解,但不能见X就删
第6关664个字母不含J,从开头按两字母分组也没有同字母对,符合Playfair结构。worker用本地已有英语四元组统计进行模拟退火,第17次重启得到完整连贯明文。
可用的5×5方阵如下,I/J合并:
K E V I N
H C T O R
B A L U G
D M F S P
Q W X Y Z
解密时,同一行各左移一格,同一列各上移一格;不同行不同列则取矩形另两个角,保持各自所在行。整个方阵循环平移行或列可形成等价密钥,所以不能看到第一行KEVIN,就断言已经知道最初的口令来源。
带填充明文为664字母,去除确认的8个填充X及末尾补齐用Q后,正文655字母,口令为 MOLYBDENUM。不能直接全局删除X:SIX、CONTEXT、ADFGVX、NEXT里就有真实X。
验证脚本从去填充正文重新按规则插回,再加密,完整恢复664个密文字母。正文还告诉我们下一关是“更复杂的ADFGVX型密码”,并暗示可能使用德语。这才是向第7关传递的有效线索。
六、第7关:从COMPUTER八符号,到881×8列的配对
标准ADFGVX用六种坐标符号;这关却只有 C O M P U T E R 八种,密文长度7048,又恰好等于 881 × 8。因此优先考虑扩展到8×8坐标表,再做8列换位。
把密文依次切成八个长度881的块 B0…B7,块0、2、4、6的频率分布形成一类,块1、3、5、7形成另一类,像是分别承载行坐标与列坐标。把两类块在相同位置配成符号对,统计这些“二符号字母”的重合指数:
| 块对,零基 | 配对IC |
|---|---|
| 0、7 | 0.06715 |
| 2、1 | 0.06769 |
| 4、3 | 0.07037 |
| 6、5 | 0.07033 |
其他配对约为0.026—0.032。这个差距让正确配对浮出水面,不需要一上来就猜整段德文。
重排四组字符流并做替换分析后,得到开头 Pierre de Fermat wurde am 20.August 1601...。精确操作为逐行读取:
B2[r], B1[r], B4[r], B3[r], B6[r], B5[r], B0[r], B7[r]
每两个符号查下面的表;␠为空格,?是本消息从未使用的格:
      C O M P U T E R
  C   5 J a U d e V E
  O   I A 1 L q 2 W ?
  M   T K j m ? B t r
  P   c Z k n C u y D
  U   O i l ? ␠ 3 w P
  T   6 0 . o p ? b ?
  E   ? S ? M N v s z
  R   H ? f G R g F h
全文3524字符,是费马生平,结尾直接说所求词是Edison。56个实际用到的坐标全部确定,8个未出现格无法仅凭这条消息唯一补齐,因此保留未知,而不是为了把表填满编造字符。
更重要的是下一句:第8关图中的转子1、2应当互换,初始窗口、环位和插线仍未知。早期第8关任务已经按原图方向做了探索;新线索到来后,主agent取消旧任务,把程序交给正确转子版本继续。并行探索不能替代依赖更新,否则只是在错误机器上搜索得更久。
七、第8关:解出Enigma,不等于唯一还原实体机器设置
交换图中转子后,对应标准Enigma左、中、右为 III / II / I,反射器B。worker修正搜索程序及缓存状态表,遍历17,576种信号初态,再对插线作重合指数爬山。
初步输出不是整齐答案,而是:
DASCLHESUNHSWORTCISTCLLUTO...
从这些近似德语词形提出 DASXLOESUNGSWORTXISTXPLUTO... 作为候选明文片段,再解插线互换约束,恢复六对连接。这个crib是在搜索已经接近答案之后提出的,不能改写成“起初就知道完整开头”。
一组有效代表参数是:
转子左/中/右:III / II / I
反射器:B
环位:AAA
第一次按键前窗口:AGL
插线:AS EI JN KL MU OT
Enigma必须先步进、后通电,还要处理双步进。右转子I的缺口为Q,中转子II为E;环位影响电气偏移,但不能随意改变窗口中可见的缺口字母。独立Python实现另用左I/中II/右III、AAA环/AAA窗口、无插线的标准测试配置,验证 AAAAA → BDZGO、HELLOWORLD → ILBDAAMTAZ,并检查 ADU → ADV → AEW → BFX 双步进轨迹。这些测试配置不等于本题的III/II/I与AGL代表密钥。
370字母完整解开,开头就是“所求口令是PLUTO”,并能370/370重新加密一致。
但AAA不是被证明唯一的原始环位。恢复插线和全文后,程序审计了 26^5 = 11,881,376 个环位/初态等价类;慢转子环与窗口共同平移的等价性单独处理。最终有12类、共312个物理设置,都由独立实现验证了全篇一致。有限长度消息没有触发足够多的缺口行为,无法区分所有原始机械设置。
九位的“一个byte”,当时不能静默删掉
明文说发现了下一关密钥最左侧的一个byte,却列出:
110100111
确实是九位。worker逐个数字词对照密文和照片,确认不是OCR多了一个词。离线阶段我们保留了多种解释:一个存储字节加一个额外位、删一位后的不同前缀、或者压缩有效密钥位的前缀。不能挑喜欢的解释,把歧义从报告里擦掉。
事后联网读原团队报告第29—30页,才确认其解释:DES每7个有效位后插一个奇偶校验位,这九个写出的位中,第8位就是校验位;因此给出的是八个有效密钥位,留下48个未知有效位。这个澄清不能倒灌成当时已知的确定结论。
八、第9关:从“CPU要44天”到GPU搜索,以及真正拖慢它的磁盘
1. 测试向量成功,不代表主密文已经解开
第8关下半页给出的密钥 0716150413020110,确实满足:
DES加密("DEBUGGER") = 346780fe5d4dfcf1
它的作用是校验DES实现,不是第9关密钥。把它用于第9关,得到的仍是乱码。主密文UU解码后为1112字节、139个DES分组;begin 600 中的600只是文件权限。
初轮尝试本地词典、派生方式和提示前缀,没有可信命中。简单OpenSSL搜索器四线程约3706万候选/秒;理想外推到16核,扫描49个未知有效位的一个前缀分支约需43.95天。
这个估计对“该实现、该外推、该空间”有意义,不是密码问题的理论下界,更不是应该停止的理由。我要求继续研究,而不是把慢CPU原型的速度当作硬件上限。
其他支线也真实失败了。旧PRNG搜索覆盖明确的种子区间及映射,累计约53.7亿次候选检测,包含重复有效密钥;留下的短块候选经全文核验全部否定。它没有发现生成器弱点,也不能据此排除所有PRNG。
2. GPU不是坏卡,是我的白名单挡住了它
普通CUDA初始化与管理查询失败,早期记录只能说“当前不可用”。主agent继续查阅本机已有说明,才发现是我设置的GPU任务白名单在拦截;不能把受限入口的失败解释成5090坏了。
在我明确授权后,主agent仅为本次固定程序添加临时单任务入口:先探测,再自检和有限测速,审核后才允许固定范围长扫。没有关闭全局守卫,没有改驱动,没有授权任意shell或整个用户环境。
收尾时只移除本任务授权及对应运行副本,保留其他任务和期间新增的合法配置,守卫继续运行。这个过程的重点不是“绕过限制”,而是识别限制、获得授权、最小化变更、精确撤销。
3. 每线程32个密钥,而不是32次标量DES
CUDA worker实现的是位切片DES:一个32位寄存器的每一位对应一个候选,把32个密钥的同一逻辑位排成一个位平面。DES的置换变成线路重排,S盒变成布尔电路,可同时作用于32条候选。
生成器把S盒真值表转成LUT3电路,利用GPU的三输入逻辑指令;经过变量顺序与公共表达式优化,每轮八个S盒合计350个LUT3。轮函数、置换和密钥调度展开,实测168个寄存器/线程、零spill。标准向量、随机密钥交叉对照和人工藏钥搜索先通过,才对真实数据长扫。
没有可靠已知首块,所以不能把 The code 之类猜测写成唯一匹配目标。程序从后续块开始筛选:
ECB:P_i = D_K(C_i)
CBC:P_i = D_K(C_i) XOR C_(i-1),i >= 1
先筛一个块的可打印ASCII、TAB、LF、CR,仍有存活候选才继续后两个块。通过24字节筛选后交给CPU解全文,检查可读性和RSA说明结构。这样可同时检查ECB及不依赖未知IV的CBC后续块,但不覆盖压缩明文、所有非ASCII文本或所有模式;报告明确保留这个边界。
4. kernel有70G,墙钟为什么只有25G?
有限测速的GPU kernel中位数为 70.370G keys/s。正式搜索前800个chunk,却只有 25.906G keys/s。
不是GPU突然降到三分之一,而是每个 2^32 候选chunk约61毫秒,程序却每批都对候选日志和检查点进行多次同步落盘。机械硬盘上的fsync,把端到端时间吃掉了。单看kernel计时,会得到非常漂亮、也非常误导的成绩。
主agent在chunk边界安全暂停,要求v3改为约10秒一批持久化:先追加并同步候选记录,再原子提交覆盖检查点;停止、命中和范围结束必须立即flush。若崩溃,最多重跑尚未提交的一批,可以有重复日志,但不能跳过未持久化的搜索范围。
这不是粗暴删除fsync,而是在可恢复语义下减少同步频率。新增状态测试覆盖批次提交、崩溃时序、停止与恢复。优化后后续扫描的真实端到端速度达到 68.398G keys/s,已经包含CPU核验和I/O。
我还提醒了另一个环境误判:**给人通过SMB访问的资料目录,不等于程序必须在那里运行。**资料保存在机械盘共享目录,并不意味着编译、中间文件和后续计算也要留在那块盘。后续工作迁到NVMe,最终证据再归档回原资料区。这里不要混淆因果:68.398G这个已测改善来自批量提交,不能全部归功于迁盘。
5. 命中了19.03%,不是扫完了整个DES
离线时,九位线索有歧义,搜索先选了与其中一种解释相容的47位优先子区。它同时位于后来确认的48位空间中,但优先次序不等于证明未知位只有47个。
实际运行统计是:
- 检查 26,787,711,025,152 个候选,约26.79万亿;
- 累计搜索运行 473.977秒,包含搜索循环核验与I/O,不含开发、编译、暂停修改;
- 到优先
2^47区域的 19.033813% 时命中; - 折合正确解释下完整
2^48空间的约 9.5169%; - 状态是
found,不是complete,没有继续扫剩余空间。
得到标准奇校验表示的密钥:
d3cd1694cba126fe
模式为DES-ECB。正文先引用《奥赛罗》,真正首块是 O! curse,之后直接写出:
Your token for this one is "Armstrong".
这也说明没有用猜测首句硬卡搜索是对的。
6. 真钥找到以后,仍有三块乱码
密钥正确不等于转录正确。明文大段连贯,偏偏三个分组损坏,其中一个位于第10关RSA模数中。独立审计对每个坏块枚举仅影响该块的单UU字符替换,每块645个有效候选,再回看高清字形。
| 数据行/字符位置 | 初始转录→校订 | 恢复的8字节 |
|---|---|---|
| 18 / 11 | O → 0 |
8109 075 |
| 22 / 60 | S → $ |
much, m |
| 23 / 17 | 2 → Z |
er to br |
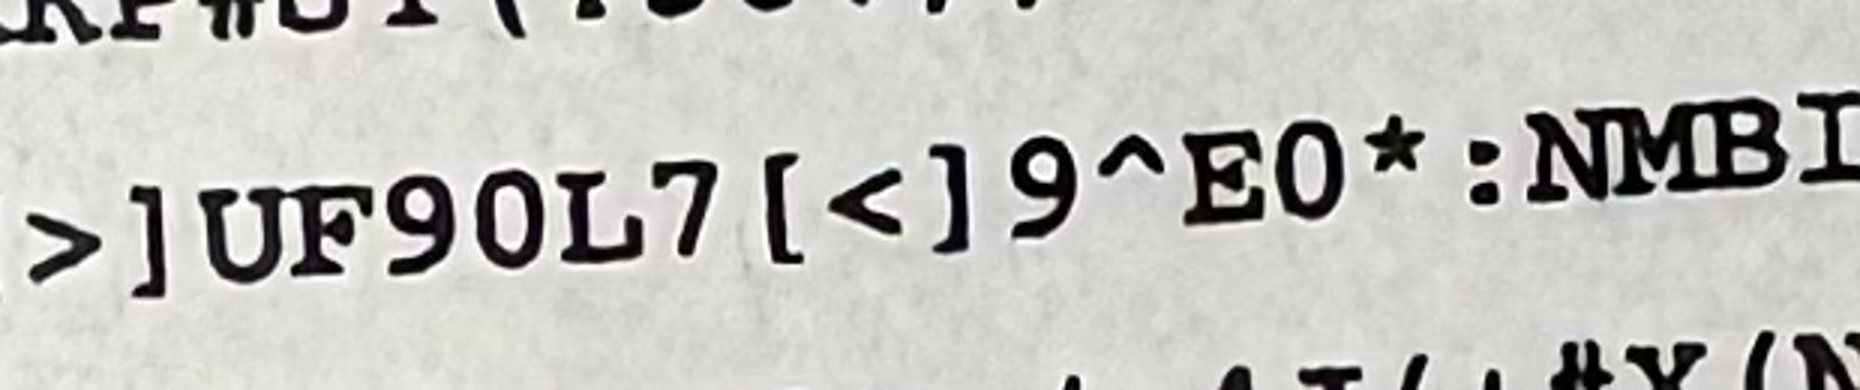
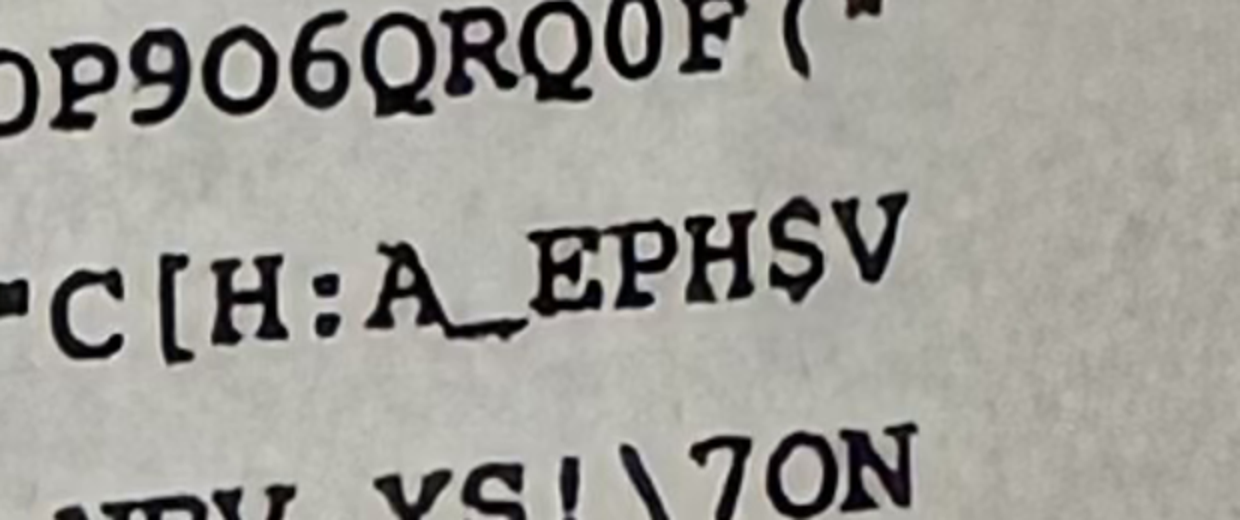
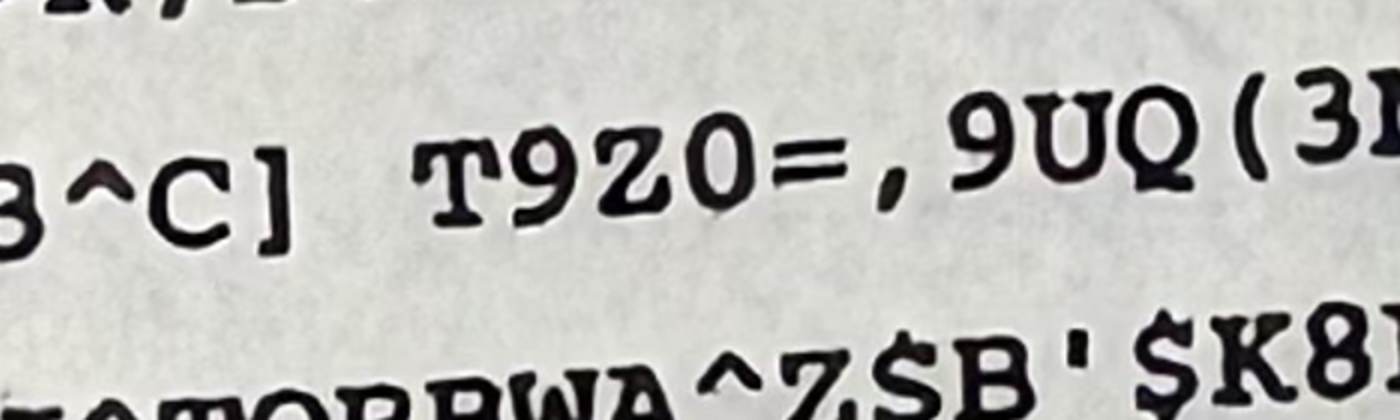
行号不含begin行,字符位置包含行首长度字符。模数坏块只有一个满足数字/空白条件的候选;另外两块各有两个全ASCII候选,不能只靠“可打印”决定,必须结合照片中美元符号的突出笔画、Z与2的字形及上下文排除。
校订另存,原UU和原二进制不覆盖。最终1104字节正文完整可读,另有末尾8字节 961eb0cc7b342c00,原样保留。不能看着像填充就强行按PKCS#7删除。全部1112字节用独立DES实现解密并重新加密一致,真实RSA公钥至此才可靠落地。
九、第10关:模型记忆不是证据,说明文字也未必等于实际算法
1. 错模数、错因子,以及IDEA支线
第10关有一个155位十进制短密文和200字节长密文。真实公钥到来之前,模型尝试从已有知识提出历史参数候选。一个貌似熟悉的N,实测竟可被 27 整除;除去27后仍是合数。另一些记忆版本长度不对、比密文还小,或所谓p、q本身是合数且乘积不等于N。
这些都没有被包装成“成功分解”。大整数看起来像真的,并不意味着每一位是真的;独立worker对候选做数字编辑、前缀重构和区间约束,负结果同样留下来。
另一路根据128位密钥与8字节分组结构尝试IDEA。它实现并测试了算法、模式和会话密钥解释,扫描有限的词典派生候选,仍无有效全文。200字节恰好是8的倍数,本来就不能区分DES和IDEA。后来真实第9关说明到来,明确指向EDE Triple-DES,这条IDEA猜想才失去题面依据。
这类试错有价值,但价值是排除明确的有限假设,不是搜索次数够大就自动证明剩下的故事。
2. 真N来了,历史q候选才终于能验
第9关恢复出155位、512bit的真实N,指数为:
N = 10742788291266565907178411279942116612663921794753294588877817210355464150980121879033832926235281090750672083504941996433143425558334401855808989426892463
e = 3735928559 = 0xDEADBEEF
主agent已有知识给出的q候选,此时可以做最简单也最关键的检查:N % q == 0。精确求商得到p,再做本地素性检查与乘积确认:
p = 12844205165381031491662259028977553198964984323915864368216177647043137765477
q = 836391832187606937820650856449710761904520026199724985596729108812301394489219
p是77位,q是78位。此前高位补全测试曾把q按77位摆放,即使前缀正确,搜索区间也整体错一个数量级,当然找不到。
主agent还用q的前46个十进制数字做Coppersmith补全。思路是写成 q = a + x,把未知尾部限制在小范围,用格归约得到候选,再以gcd和精确乘积验证。按78位总长设置后,恢复出相同完整q;按77位则失败。
这是一项已知大量高位条件下的补全交叉检查,不是从零分解未知512位半素数,也不能把空结果一概解释为前缀一定错误。工具早期在控制样本上还遇到过浮点精度导致的假阴性。
3. RSA结果很好看,3DES却仍然全是乱码
以 λ = lcm(p−1,q−1) 求 d = e⁻¹ mod λ,再计算 m = c^d mod N,得到:
m = 93276604708370087173009055328787452322
16字节大端:462c6bad381031ad64dccd9820a751a2
K1:462c6bad381031ad
K2:64dccd9820a751a2
m实际为127bit,按16字节表示,16个字节全部满足DES奇校验。Python大整数与GMP计算一致,且 m^e mod N 精确还原短密文。至此RSA链条有很强的验证。
但按第9关说明,标准双密钥EDE应当使用K1、K2、K1;实际解出来却是乱码。主agent又测试大小端、交换两半、不同字节分组与位序、正反方向等,保存的6784个变体仍没有完整正文。
如果在这里反复修改已通过验证的RSA参数,很容易把正确部分也毁掉。更合适的动作是拆开对称运算,检查说明与数据是否真的一致。
4. 936个简化组合里,答案是单独一次D_K1
后续审计检查了936个简化DES运算组合。命中者不是复杂的新排列,而是:
P = DES-ECB-Decrypt(K1, C)
即仅用前8字节K1做一次单DES解密。完整正文出现:
For secrets are edged tools and must be kept from children and from fools.
The magic word you need to quote is DRYDEN.
Congratulations, you have solved the tenth and final stage of the challenge.
正文198字节,末尾还有 e7 06 两字节。它们和第9关尾部一样原样保留,全部200字节参与重新加密。
随后用libgcrypt实际DES、OpenSSL命令行DES,以及cryptography中三段相同密钥的等价路径交叉验证:每条先过标准测试向量,再解全篇、重新加密原密文。标准 EDE(K1,K2,K1) 明确不匹配,单DES(K1)明确匹配。
可以证明:若加密顺序为 E(K1) → D(K2) → E(K2),后两步抵消,效果等于单DES(K1)。但这只是数学等价关系,不能据此编造“原程序一定把某个数组下标写错”。我们没有当年的源代码。
5. 原团队二十多年前也踩过同一个坑
全部离线完成后获准联网,才读到获胜团队报告第37页:他们得到因子和对称密钥后,也按3DES解出乱码,尝试交换64位密钥块、反转位序,折腾约一小时,最后在中间文件P1中发现正确明文。
原文明确说:
It was only protected by a single DES key.
2000年的采访报道也记录了出题方承认本来想用三重DES,却意外做成单DES。它证实了历史不一致,却仍没有给我们具体实现缺陷的源码证据。
这次最戏剧性的地方不是AI预知了这个坑,而是它先被错误说明卡住,独立实测发现单DES,最后才在历史报告里看到同样的经历。
十、“十关全部PASS”究竟验证了什么
最终统一验证没有重跑GPU长扫,而是用保存的密钥、明文和证据,完成本地CPU复核。
对古典密码,检查全文映射和全部符号的重新加密;对同音替换与书本密码,明确携带非唯一选择记录;对Enigma,用独立实现检查步进、环位等价和370字母全文;对第9关,检查图像支持的三处校订及1112字节完整回验;对第10关,检查因子乘积、素性测试、RSA等式和200字节对称密文。
但**“解密后能重新加密回去”本身,不证明密钥正确**。对一个正确实现的分组密码,错密钥产生的乱码也能原样加密回去。真正的证据链需要同时有:
- 来源可靠、变更有记录的输入;
- 标准向量与独立实现验证;
- 连续完整的自然语言或可验证结构;
- 来自前关或数学检查的密钥来源;
- 全量回验,而不是只匹配一个答案词。
十个首字母组成ONE TIME PAD,只能算这条链末尾的一项附加一致性。原始失败日志没有删除,最终README与验证JSON明确区分“早期未解”“工具自检成功”和“实际题目解出”。
十一、原团队378天,我们2小时28分:怎样比才公平
事后下载的原团队报告是2000年10月11日的《How we Cracked the Code Book Ciphers》,共40页,作者为Fredrik Almgren、Gunnar Andersson、Torbjörn Granlund、Lars Ivansson、Staffan Ulfberg。Simon Singh的官网介绍链接了这份报告。
十个口令全部吻合,包括双L的ILLIAD;第9关密钥和第10关真实整数也一致。时间对比则必须拆开口径:
| 项目 | 原团队 | 本次 |
|---|---|---|
| 总历时 | 首题到末题378天 | 最后全文2小时10分;复核交付约2小时28分 |
| 第5关 | 前四关完成后又卡224天 | 约第69分钟完成独立核验 |
| 第9关 | 分布式搜索约三周,累计约一个CPU年 | 搜索运行473.977秒,另有开发与修改时间 |
| 第10关 | 真正完成GNFS分解与后续解密 | 用历史因子候选经真N验证,没有重做GNFS |
378天不是全天不停工作;224天主要说明找底本的认知瓶颈,不是224天连续扫描。原团队第9关约搜了完整 2^48 的17%,我们约9.52%,命中位置不同,不能简单用三周除以7分54秒就宣称严格算法加速倍数。他们当时也使用32路位切片与ASCII早退,并非没有优化思想。
第10关更不能拿“13天”当历史全程。原报告描述的是:大量工作站收集关系,关系过滤约三周,大型线性代数阶段约13天,最后平方根约11小时,获得因子后再处理对称算法问题。最初约40个CPU年的数字是估算,不是已核实的最终总账。
他们是首次探索者,使用当年的硬件,真的做了通用数域筛。我们有现代GPU、并行模型、我提供的提示、现成密码库,以及模型已有知识中的历史因子。离线不等于没有历史知识,不能以“没有浏览器”证明这是一场无污染的从零测试。
所以我愿意说的是:**现代AI把知识候选、工具生成、实际计算和验证串起来,在一个晚上完成了这次任务。**我不愿意说的是:“它在同等条件下把当年的所有工作加速了几千倍。”
十二、Token与API价格:不是只统计主agent,也不是实际扣款账单
统计窗口严格固定为首次发题到首次“十题全部解出”交付:2026-10-24 14:01:22.626—16:29:03.169 UTC。随后联网核对、本文撰写、附件制作和网站发布均不混入。
| 来源 | 未缓存输入 | 缓存读取 | 输出(已含reasoning) | 总token | API等价估算,USD |
|---|---|---|---|---|---|
| 主会话 | 395,329 | 29,972,224 | 149,751 | 30,517,304 | $46.631795 |
| 原16个子任务 | 691,922 | 20,779,648 | 419,505 | 21,891,075 | $48.674118 |
| 合计 | 1,087,251 | 50,751,872 | 569,256 | 52,408,379 | $95.305913 |
缓存写入为0。也就是说,这次留下记录的用量约为5241万token,API等价约95.31美元,其中约96.84%是缓存读取。它们是多轮请求反复处理上下文的累计量,不是生成了五千多万token的新文章。主会话输出中的94,975个reasoning token已经包含在149,751个output中,不能再加一次;子任务的reasoning拆分未保存,也不能擅自填0。
单价、长上下文与复算
价格于2026-10-25核对。按本次联网核实的官方模型页和定价页,GPT-6 Astra Standard每百万token价格为:
| 输入范围 | 未缓存输入 | 缓存读取 | 输出 |
|---|---|---|---|
| 单次输入不超过272K | $10 | $1 | $50 |
| 单次输入超过272K | $20 | $2 | $75 |
超过阈值时,对整次请求应用加价,不是只对超出的部分加价。缓存写入另有价格,但本次记录量为0。Batch、Flex、Fast有其它倍率,不在这里擅自替换实际日志里的费率。
主会话有210条usage记录:191条普通费率、17条长上下文费率、2条error零用量记录;逐条费用与本地计费代码、模型价目表重算吻合。子任务有608次assistant消息结束计数;其累计费用与普通费率重建相符,但没有保存逐请求明细,不能把累计计数伪装成完整账单。
单次请求的基本复算是 未缓存输入×输入价 + 缓存读取×缓存价 + 输出×输出价,最后除以一百万,并先判断该次请求的长上下文档位。不能把所有token统一乘输入单价,也不能先加总所有轮次再拿总量判断272K阈值。
16个子任务也有失败成本
下表编号对应前文分工表;金额采用记录值,包含取消任务此前已上报的消耗。
| # | 简称 | 已记录token | API等价估算,USD |
|---|---|---|---|
| 1 | 第1—3关 | 777,351 | $2.241118 |
| 2 | 第4—6关 | 1,076,211 | $2.187526 |
| 3 | 第7关 | 2,444,348 | $4.283496 |
| 4 | 第8关初轮,取消 | 549,761 | $1.373466 |
| 5 | 第9关初轮 | 2,769,626 | $4.954660 |
| 6 | 第10关初轮 | 864,552 | $2.237568 |
| 7 | 第5关错误底本搜索,取消 | 2,367,641 | $4.938130 |
| 8 | 第8关正确转子 | 976,283 | $2.287270 |
| 9 | 第5关费马底本 | 733,855 | $2.006102 |
| 10 | 历史参数/高位补全,取消 | 1,310,930 | $3.459788 |
| 11 | 第9独立审计与纠错 | 2,928,576 | $5.739544 |
| 12 | 第10混合加密与最终复核 | 2,440,772 | $5.320800 |
| 13 | CUDA位切片 | 2,030,129 | $4.964922 |
| 14 | 旧PRNG支线 | 350,537 | $1.486802 |
| 15 | 独立历史候选 | 74,592 | $0.526816 |
| 16 | 真N因子任务,取消 | 195,911 | $0.666110 |
完整可机器复算的数据在脱敏usage附件,字段解释在用量审计口径。
能看到多少子agent记录,必须说实话
这套managed子agent扩展使用了 --no-session:任务结束后并不存在16份完整的落盘子会话。主会话保留了下发任务、请求父协助、回复及结果;运行中的父控制器则仍保留每个子任务累计usage。
为这次统计,只从父控制器读取了原16个任务白名单的用量数值、模型、终态和时间戳,没有转储堆、导出消息内容、隐藏推理或凭据,也没有重载扩展去破坏仍在内存里的计数。临时只读检查入口随后关闭。公开附件不含私有进程信息和调试脚本。
因此这些数值可称为已记录累计用量,但不能装成服务商结算发票:取消或失败时如果没有回传usage,真实额外消耗仍未知;恢复同一任务不会作为新任务重复计数。四个取消任务已有的消耗照样计入。
本次接入是Codex订阅/OAuth路径,Pi显示的美元数是API等价估算,不是订阅账户按token实际扣款。也不包含本地电费、硬件摊销及本轮写作发布成本。会话墙钟、本地搜索运行量、云端token和实际付款是四种不同指标,不能互相代替。
十三、这次真正值得留下来的方法
对我而言,最有用的不是“16个agent”这个数字,而是几次改变走向的动作:
**把停下的理由变成可以检查的假设。**CPU估算44天,意味着检查实现和可用硬件,不意味着任务无解;几百万次错误底本未命中,意味着重新审视底本范围,不意味着book cipher方向被排除。
**让人类负责现实约束,AI负责执行与举证。**我提供提示、明确批准单任务GPU授权,并指出SMB目录的实际用途;主agent则从本地说明查清了白名单限制。AI不能把这些现实信息靠猜测补齐,更不能为了跑快而破坏安全配置。
**让快的搜索和慢的怀疑并存。**GPU负责数万亿候选,独立worker负责怀疑三处字符;数学验证保护正确的RSA链条,运算审计挑战错误的3DES说明。只追求吞吐,没有输入审计,可能以极高速度验证一份错题。
**允许结果有边界。**Playfair方阵可以等价,Enigma环位不唯一,坐标表有未出现格,模型记忆需要验证,尾部字节未必能解释。把这些写出来,不会削弱答案,反而让答案可以被别人检查。
最终不是AI凭一句“我知道答案”赢下这套挑战,而是一条可追踪的链:照片、转录、假设、程序、失败、授权、搜索、校读、独立复核。模型可以提出有用的候选,也会说出貌似精确的错误长整数;工具和证据决定哪些留下,哪些必须丢掉。
公开资料与复现入口
原始公开来源:
- Simon Singh:Cipher Challenge历史与说明
- 官方十关密文入口
- 获胜团队与报告介绍
- 团队原报告PDF:第18页核对第5关,第29—33页解释DES线索与搜索,第34—37页记录GNFS与单DES问题。
- The Register,2000年10月13日:出题方的单DES失误
作者官网也提醒,网页密文未必与所有印本逐字相同。因此,复现应明确使用哪份转录,不能混用网页与照片差异后仍声称同一输入。
公开复现材料:
包内保留初始转录与校订差异、固定密钥、必要数据和验证代码,不包含完整会话、隐藏推理、凭据、设备唯一标识或私有环境路径;也不把14张完整书页和40页团队报告重新托管。校读示例只展示必要的局部字形。按包内说明准备本地依赖后,在解压目录运行 python verify_all.py 做CPU复核;它不会下载资料或启动GPU密钥搜索。
这份复现包提供的是已知恢复密钥后的验证,以及部分分析/搜索源码,不是“一键从零重新发现十题全部密钥”。CUDA全范围搜索另需明确选择,不能把昂贵搜索藏在默认核验入口里。
DISCUSSION